Die besten 14+ KI-Text-zu-Sprache Tools für 2026
Zuletzt aktualisiert: 25. August 2026
Die Umwandlung von geschriebenem Text in natürlich klingende Sprache eröffnet neue Möglichkeiten für Audioinhalte und Zugänglichkeit. KI-Text-zu-Sprache-Tools konvertieren Skripte in realistische Sprach-Audio, mit Kontrolle über Ton, Tempo und Sprache.
Diese Tools werden häufig von Content-Erstellern, Entwicklern und Zugänglichkeits-Teams verwendet, um Videos, Apps und Artikeln eine Stimme zu verleihen. Hochwertige, natürlich klingende Stimmen haben Text-zu-Sprache zu einer praktischen Alternative zur Einstellung von Synchronsprechern für viele Projekte gemacht.
 ElevenLabs
 ElevenLabsRealistische KI-Sprach- und Audio-Tools,
 Chat Slide
 Chat SlideDokumente sofort in professionelle Präsentationen und Videos verwandeln und
 VoxImplant
 VoxImplantCloud-Kommunikations-APIs für Sprach-, Video- und KI-Kontaktzentren sind die besten für KI-Text-zu-Sprache. Werfen wir also einen genaueren Blick auf alle 14+ Tools.

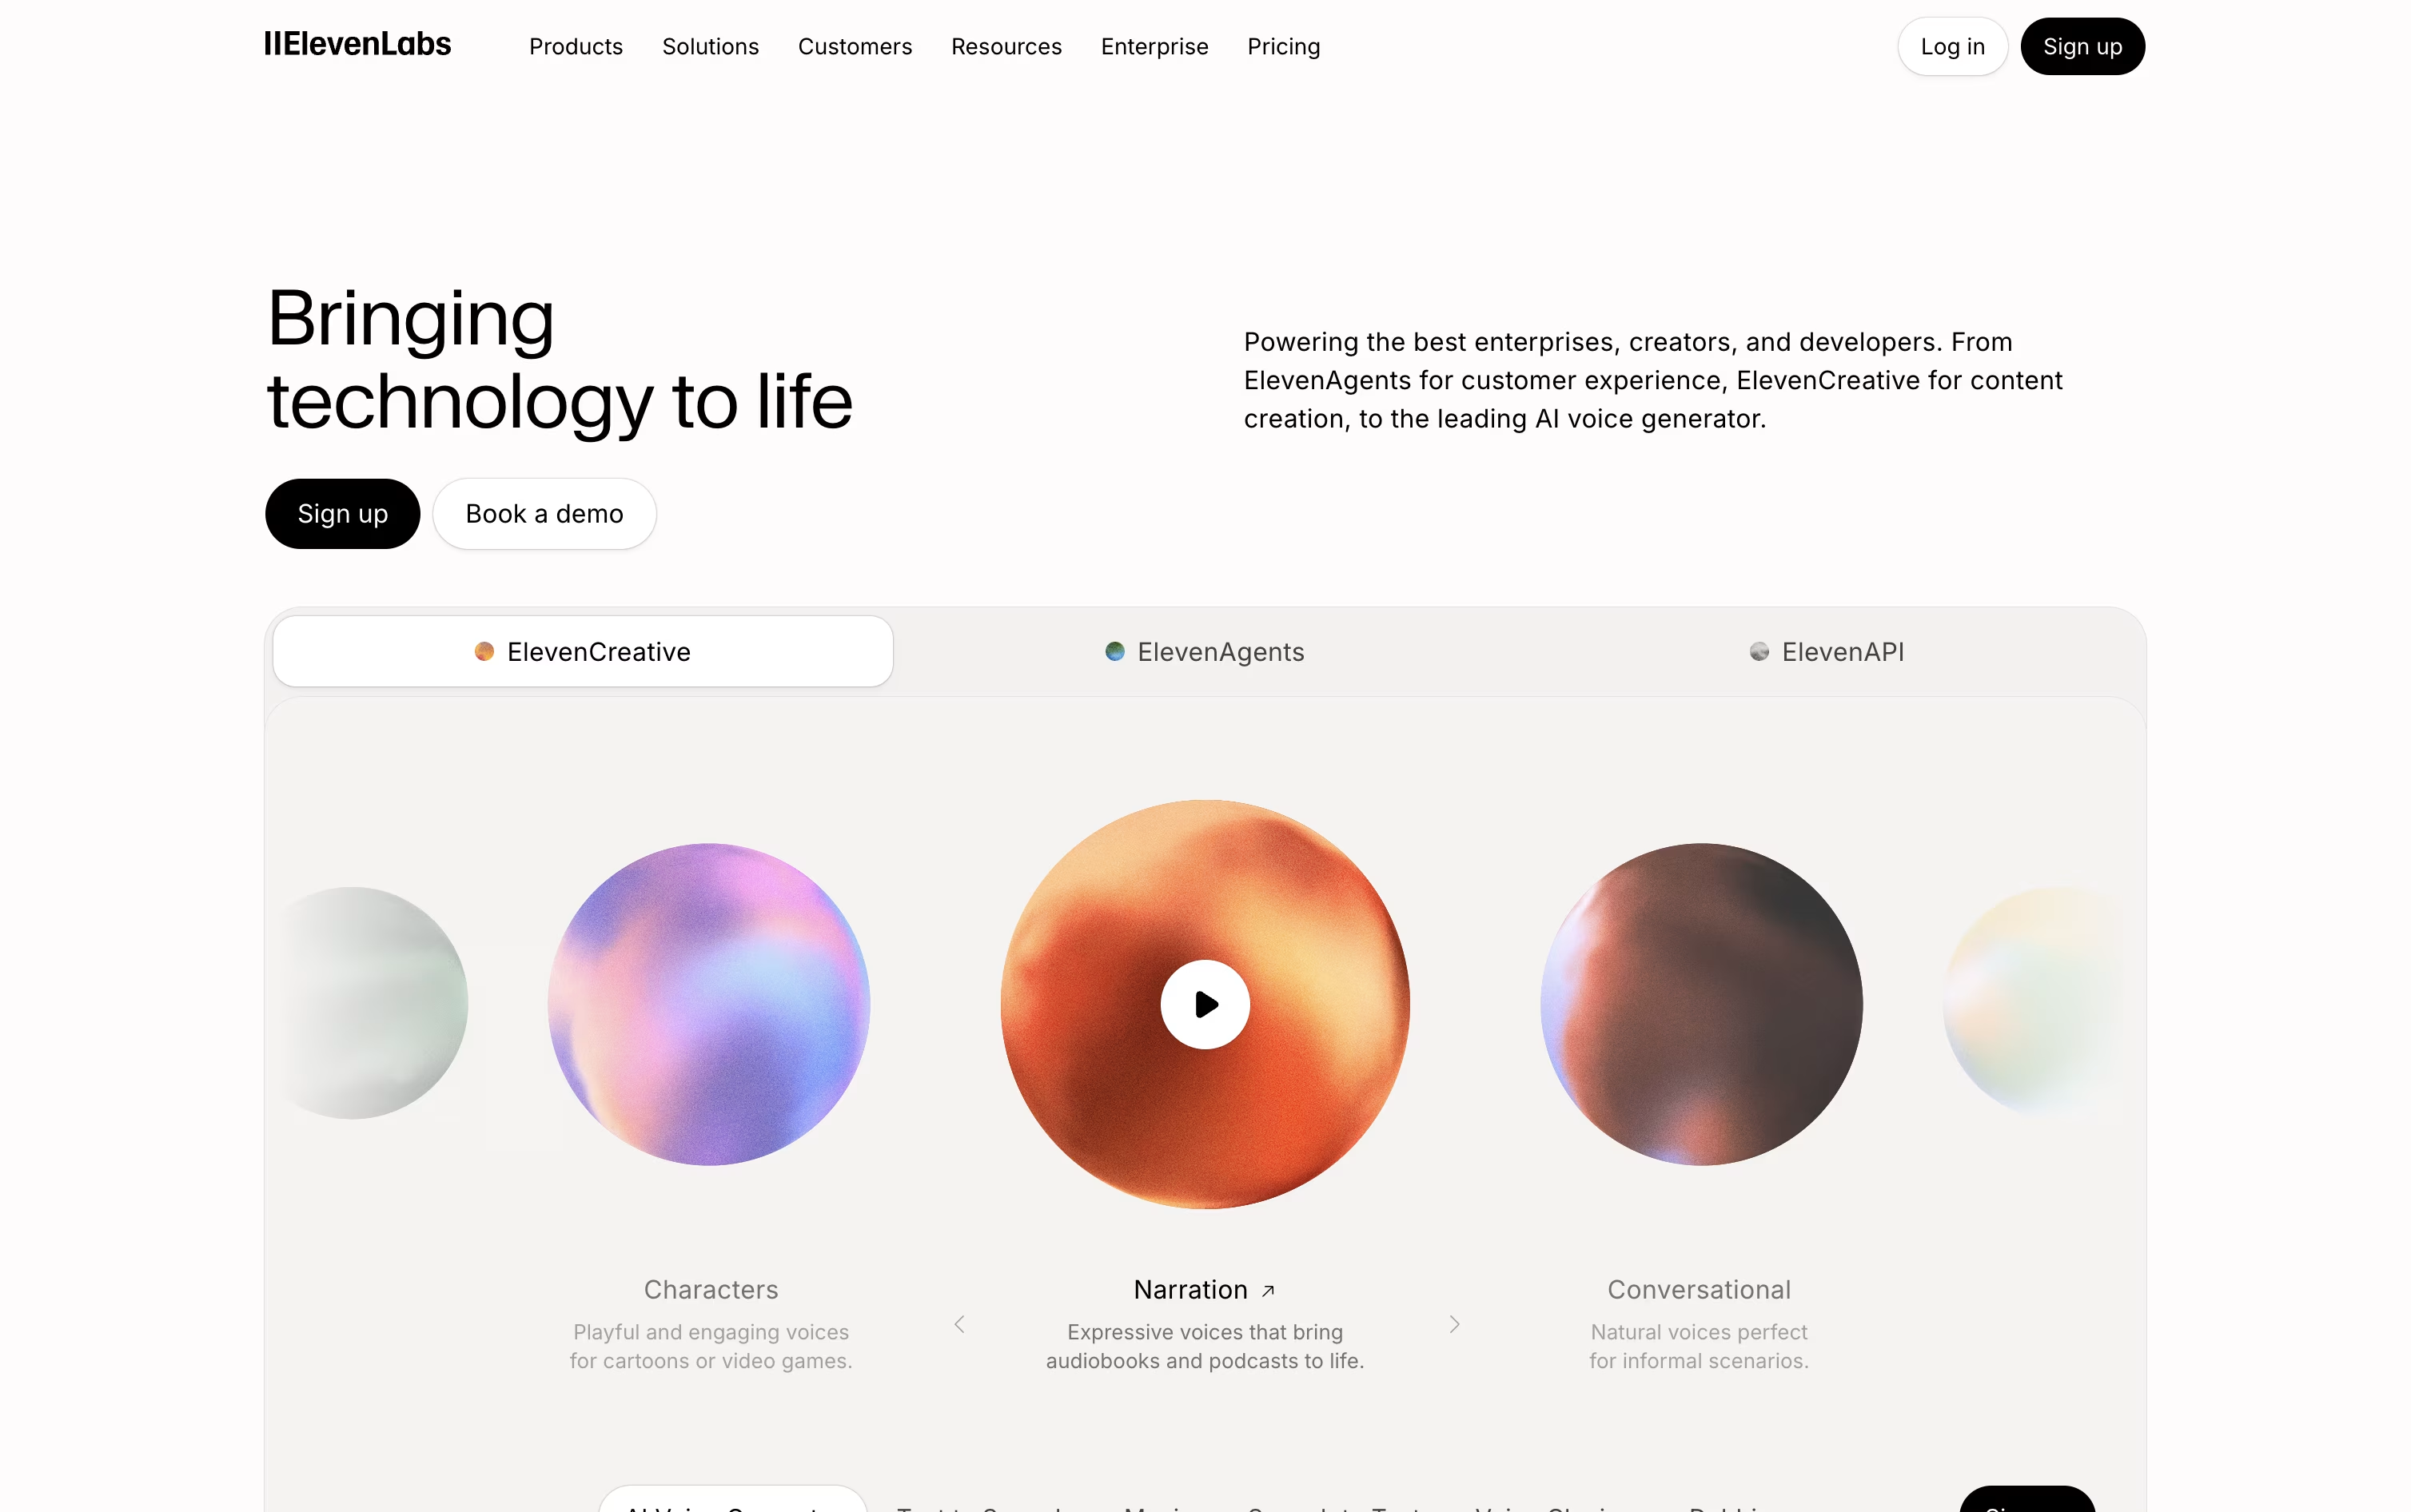
ElevenLabs ist vor allem dafür bekannt, KI-Sprache zu erzeugen, die tatsächlich menschlich klingt, mit natürlichen Pausen, Tonfall und Emotionen statt einer monotonen Roboterstimme. Neben der Sprache kann es eine Stimme aus einer kurzen Probe klonen, Videos in Dutzende von Sprachen synchronisieren, Musik und Soundeffekte erzeugen und Sprachagenten betreiben, die mit Kunden am Telefon oder im Chat sprechen.
Es gibt drei Hauptverwendungsmöglichkeiten. ElevenCreative ist ein webbasiertes Studio für Content-Ersteller, die Podcasts, Werbung und kurze Videos erstellen. Mit ElevenAgents können Sie Konversations-Sprach- und Chatbots entwerfen und starten, ohne Code schreiben zu müssen. ElevenAPI öffnet Entwicklern dieselbe Technologie über eine REST-API mit fertigen Python- und JavaScript-SDKs.
Der kostenlose Plan bietet 10.000 Credits pro Monat, sodass jeder die Grundlagen kostenlos ausprobieren kann. Starter kostet 6 $ pro Monat und fügt kommerzielle Lizenzierung sowie sofortige Stimmklonierung hinzu. Creator, die beliebteste Stufe, kostet normalerweise 22 $ pro Monat, manchmal im ersten Monat für 11 $ angeboten, und beinhaltet professionelle Stimmklonierung mit einem viel größeren Kreditrahmen.
Größere Anforderungen werden durch Pro für 99 $ pro Monat, Scale für 299 $ pro Monat mit geteilten Workspace-Sitzen und Business für 990 $ pro Monat mit zehn Sitzen und günstigerer Sprache mit geringer Latenz abgedeckt. Die Enterprise-Preisgestaltung wird direkt mit dem ElevenLabs-Team besprochen und beinhaltet individuelle Sicherheit und Prioritäts-Support.
Da jeder Plan auf denselben zugrunde liegenden Sprach- und Audiomodellen basiert, sinkt die Qualität nicht, wenn Sie hochskalieren, egal ob Sie ein einzelnes Video produzieren oder Tausende von Live-Kundenanrufen durchführen.
Chat Slide AI ist ein KI-Arbeitsbereich für Wissensaustausch, der verschiedene Arten von Inhalten in strukturierte Präsentationen, Videos und Audioinhalte umwandelt. Im Gegensatz zu herkömmlichen Präsentationstools, die eine manuelle Folienerstellung erfordern, analysiert Chat Slide Ihre Eingabematerialien und erstellt automatisch professionell aussehende Folien mit korrekter Formatierung, visuellen Elementen und Layout.
Die Plattform bietet mehrere Optionen zur Inhaltsumwandlung. Sie können Folienpräsentationen erstellen, Videos mit KI-Avataren generieren, die Ihren Inhalt sprechen, Präsentationen in Podcasts umwandeln oder Beiträge für soziale Medien produzieren. Es werden Datei-Uploads wie PDFs, Word-Dokumente, Bilder und Weblinks unterstützt.
Chat Slide verwendet fortschrittliche KI-Modelle, um Ihre Inhalte zu verstehen und passende Visualisierungen, Diagramme und Layouts zu erstellen. Das Tool beinhaltet über 100 KI-Avatare, Sprachklon-Funktionen und unterstützt mehr als 100 Sprachen. Es bietet verschiedene Preismodelle von der kostenlosen Basisnutzung bis hin zu professionellen Plänen mit erweiterten Funktionen wie individuellem Branding und längeren Videoerstellungslimits.
VoxImplant ist eine umfassende Cloud-Kommunikationsplattform, die Unternehmen und Entwicklern ermöglicht, Sprach-, Video- und Messaging-Funktionen in ihre Anwendungen und Dienste zu integrieren. Das 2013 gegründete Unternehmen mit Sitz in Palo Alto bedient weltweit Millionen von Nutzern durch seine innovative Communication Platform as a Service (CPaaS)-Lösung.
Die Plattform besteht aus zwei Hauptprodukten: VoxImplant Platform, die APIs und SDKs für die individuelle Entwicklung bereitstellt, und VoxImplant Kit, einer Omnichannel-Contact-Center-Lösung. Die VoxImplant Platform unterstützt mehrere Programmiersprachen und Frameworks, darunter iOS, Android, React Native, Flutter, Unity und Webanwendungen. Der Service umfasst fortschrittliche Funktionen wie KI-gestützte Sprachbots, natürliche Sprachverarbeitung, Anrufaufzeichnung, Transkription und nahtlose Integration mit beliebten KI-Anbietern wie OpenAI, Google Gemini und Dialogflow, was sie ideal für die Erstellung anspruchsvoller Kommunikationserlebnisse macht.
Resemble AI ist eine KI-gestützte Plattform für Sprachklonen und Text-zu-Sprache, die geschriebenen Text in natürlich klingende Sprache mit geklonten Stimmen verwandelt. Die Plattform kann Sprachkopien aus minimalen Audioaufnahmen erstellen und Sprache generieren, die bemerkenswert menschlich klingt.
Im Gegensatz zu herkömmlichen Text-zu-Sprache-Tools, die generische, robotische Stimmen anbieten, spezialisiert sich Resemble AI auf die Erstellung personalisierter Stimmen, die die einzigartigen Merkmale, den Akzent und den Sprechstil des ursprünglichen Sprechers beibehalten. Die Plattform unterstützt zwei Hauptansätze: Rapid Voice Cloning, das mit nur 10 Sekunden Audio schnelle Ergebnisse liefert, und Professional Voice Cloning, das 10 Minuten Audio für eine höhere Qualität verwendet.
Der Service umfasst fortschrittliche Funktionen wie Emotionssteuerung, mehrsprachige Unterstützung für über 149 Sprachen, Echtzeit-Sprachgenerierung und integrierte Sicherheitsmaßnahmen. Er bietet sowohl webbasierten Zugriff als auch API-Integration für Entwickler, die sprachaktivierte Anwendungen erstellen.
Alter ist ein nativer macOS KI-Assistent, der speziell für Mac-Power-User entwickelt wurde, die eine nahtlose KI-Integration in ihren gesamten Arbeitsablauf wünschen. Er funktioniert als systemweites Produktivitätstool, das den Kontext aus jeder von Ihnen verwendeten App versteht.
Das Tool arbeitet über Sprachbefehle und kontextbezogene Menüs, sodass Sie KI-gestützte Aktionen ausführen können, ohne zwischen Anwendungen wechseln zu müssen. Es kann Meetings aufzeichnen, Audio transkribieren, Inhalte zusammenfassen, E-Mails schreiben, Präsentationen erstellen und komplexe Aufgaben in Apps wie Finder, Keynote und Apple Mail erledigen.
Was Alter auszeichnet, ist sein Datenschutz-First-Ansatz. Ihre Daten bleiben lokal verschlüsselt, und Sie können KI-Modelle vollständig offline mit Ollama oder LM Studio ausführen, sodass sensible Informationen Ihr Gerät niemals verlassen.
Speechify basiert auf einer Idee: Menschen Informationen mit dem Ohr statt mit dem Auge aufnehmen zu lassen. Legen Sie eine PDF-Datei ab, fügen Sie Text ein, teilen Sie einen Link oder richten Sie die Kamera Ihres Telefons auf eine gedruckte Seite, und Speechify liest es mit natürlicher Stimme vor.
Es geht auch über einfache Erzählungen hinaus. Sie können seinen Sprach-KI-Assistenten Fragen zum Material stellen, eine kurze Zusammenfassung anfordern oder ein Quiz generieren, um zu testen, was hängen geblieben ist.
Der Einstieg ist kostenlos, mit einem kostenlosen Plan, der grundlegende Roboterstimmen und Standardlesen bietet. Der Umstieg auf Premium für 29 $ pro Monat oder 139 $ pro Jahr bei etwa 60 % Ersparnis schaltet über tausend natürliche Stimmen, Geschwindigkeiten bis zur 4,5-fachen Normalgeschwindigkeit, Spracheingabe und sofortige KI-Podcasts frei.
Wenn Ihr Fokus eher auf dem Erstellen als auf dem Konsumieren liegt, ist Speechify Studio ein separates Tool für Voiceovers, Videosynchronisation und Sprachklonen, das zwischen 100 und 300 $ pro Jahr kostet.
Es gibt auch eine entwicklerorientierte SpeechifyAI-API, die kostenlos startet und bis zu 499 $ pro Monat oder individuelle Preise für Unternehmens-Sprachagenten erreicht.
Fish Audio ist ein KI-Sprachwerkzeug, das lebensechte Sprache aus Text erzeugt und eine Stimme mit nur einer kurzen Probe kopieren kann. Es wandelt auch Sprache in Text um, tauscht Stimmen aus und bietet Soundeffekte, Audiotrennung und Übersetzungsfunktionen.
Der Einstieg ist im Free-Tarif kostenlos, der 8.000 Credits pro Monat für etwa 7 Minuten Audio und Zugang zu 3 öffentlichen Stimmen bietet.
Der Plus-Plan kostet 7,50 $ pro Monat oder 5,50 $ pro Monat bei jährlicher Abrechnung und schaltet 250.000 Credits, private Stimmslots und das Recht auf kommerzielle Nutzung von Audio frei.
Der Wechsel zu Pro bringt den Preis auf 50 $ pro Monat oder 37,50 $ pro Monat jährlich, zusammen mit 2 Millionen Credits, 3 Teamsitzen und 5 professionellen Stimmen.
Max ist für größere Teams zu 999 $ pro Monat oder 749 $ pro Monat bei jährlicher Abrechnung ausgelegt und bietet 25 Millionen Credits und 10 Teamsitze, während Enterprise individuell bepreist und auf Compliance- und On-Premise-Anforderungen zugeschnitten ist.
Für Entwickler gibt es eine API, die nur nach tatsächlicher Nutzung abrechnet und Sprachgenerierung, Transkription und Voice-Design ohne monatliche Verpflichtung abdeckt.
Murf AI ist darauf ausgelegt, geschriebenen Text in Sprache zu verwandeln, die wirklich menschlich klingt, mit über 200 Stimmen in mehr als 35 Sprachen und Akzenten. Die gleiche Plattform deckt auch Sprachagenten für Anrufe und Chat, Video-Synchronisation und Sprachklonen ab.
Der Studio-Editor gibt Ihnen Kontrolle über Tonhöhe, Geschwindigkeit, Betonung, Pausen und Aussprache und ermöglicht es Ihnen, mehrere Stimmen in einem Projekt zu mischen, bevor Sie Audio exportieren, das Sie kommerziell nutzen können.
Der Einstieg kostet nichts, da der Free-Plan 10 Projekte und 10 Minuten Sprachgenerierung umfasst.
Creator schließt sich ab 19 $ pro Monat im Jahresplan an, oder 29 $ monatlich, und schaltet 100 Projekte, 2 Stunden monatliche Sprachgenerierung, unbegrenzte Downloads und kommerzielle Rechte frei.
Business steigert sich auf 66 $ pro Monat jährlich oder 99 $ monatlich und fügt 8 Stunden Generierung sowie Betonungs-, Variabilitäts- und PowerPoint-Support hinzu.
Größere Organisationen können einen individuellen Enterprise-Plan mit unbegrenzter Generierung und dediziertem Account-Support anfordern, während Dub- und API-Preise separat nach Nutzung abgerechnet werden.
Cartesia ist eine Voice-AI-Plattform, die sich auf Geschwindigkeit und natürlichen Klang konzentriert und von den Forschern hinter State Space Models entwickelt wurde, einem Ansatz, der für schnelle Antworten und die Verarbeitung langer Kontexte ausgelegt ist.
Das Herzstück bilden drei Tools. Sonic wandelt Text in menschlich klingende Sprache um, Ink hört zu und wandelt Sprache in Text um, während es erkennt, wann ein Sprecher beginnt und aufhört, und Line kombiniert beides zu vollständigen Voice-Agenten, die Sie mit Ihrem eigenen Code steuern.
Der kostenlose Plan kostet nichts und umfasst 20.000 monatliche Credits sowie grundlegenden Zugriff auf Text to Speech und Speech to Text.
Wenn Sie aufsteigen, schaltet Pro für 5 $ pro Monat kommerzielle Nutzung und sofortige Stimmklonierung frei, und Startup für 49 $ pro Monat fügt professionelle Stimmklonierung sowie Organisationsunterstützung hinzu.
Scale für 299 $ pro Monat bietet prioritären Support und höhere Parallelität, während Enterprise individuelle Preise mit SSO und Compliance-Funktionen für größere Teams bietet.
Telefonnummern und Gesprächsminuten werden zusätzlich zum Plan abgerechnet, und jedes Abonnement kann bei Bedarf pausiert oder gestoppt werden.
Smallest AI entwickelt kompakte, schnelle KI-Modelle für Sprachgespräche, anstatt sich auf ein großes Modell für alles zu verlassen. Dieser Ansatz ermöglicht es jedem Modell, schnell zu reagieren und Sprache auf natürliche Weise zu verarbeiten.
Die Hauptmodelle der Plattform sind Lightning für die Umwandlung von Text in Sprache, Pulse für die Umwandlung von Sprache in Text, Hydra für direkte Sprach-zu-Sprach-Gespräche und Electron, ein kleines Sprachmodell, das während eines Anrufs das Denken übernimmt.
Teams, die Sprachagenten erstellen möchten, können Atoms verwenden, eine No-Code-Plattform zum Erstellen, Testen und Starten von Agenten, zusammen mit Wissensdatenbanken und Anrufkampagnen.
Die Abrechnung erfolgt auf Pay-as-you-go-Basis. Neue Benutzer starten mit 10 $ an kostenlosen Credits. Danach wird die Nutzung pro Minute für Anrufe, pro Zeichen für die Sprachgenerierung und mit kleinen Gebühren für Extras wie Wissensdatenbank-Abfragen abgerechnet.
Größere Teams können den Enterprise-Plan für individuelle Preise, dedizierte Infrastruktur, On-Premise-Optionen und Compliance-Unterstützung wählen, mit Agentenkosten pro Minute ab nur 0,05 $.
Deepgram bietet Entwicklern eine Plattform für Spracherkennung, Sprachsynthese und Echtzeit-Sprachagenten, anstatt separate Tools zusammenzusetzen.
Die Modelle Nova-3 und Flux transkribieren Audio schnell und präzise in mehr als 45 Sprachen, mit integrierter Sprecherkennzeichnung, Formatierung und Schwärzung privater Informationen.
Auf der Sprachseite erzeugen Aura-Stimmmodelle schnell natürlich klingende Antworten, und die Voice Agent API verbindet Zuhören, Denken und Sprechen zu einer einzigen flüssigen Konversation mit geringer Latenz.
Neue Nutzer starten mit Pay As You Go, das ein kostenloses Guthaben von 200 US-Dollar umfasst und danach nur für die tatsächliche Nutzung berechnet.
Growth eignet sich für aktivere Teams und kostet 4.000 US-Dollar oder mehr pro Jahr an vorausbezahlten Guthaben, mit niedrigeren Preisen für die meisten Dienste und höheren Parallelitätslimits.
Größere Organisationen können auf Enterprise umsteigen, einen individuell über den Vertrieb angebotenen Plan, der dedizierten Support, benutzerdefinierte Modelle und Optionen zur Selbsthostung für strengere Datenkontrolle hinzufügt.
Viele Teams kommen zu Inworld AI, um natürliche Stimmen zu Spielen, Apps oder KI-Agenten hinzuzufügen, ohne mehrere verschiedene Tools zusammenzustückeln. Inworld vereint Text-to-Speech, Speech-to-Text und eine vollständige Speech-to-Speech-Realtime-API auf einer Plattform.
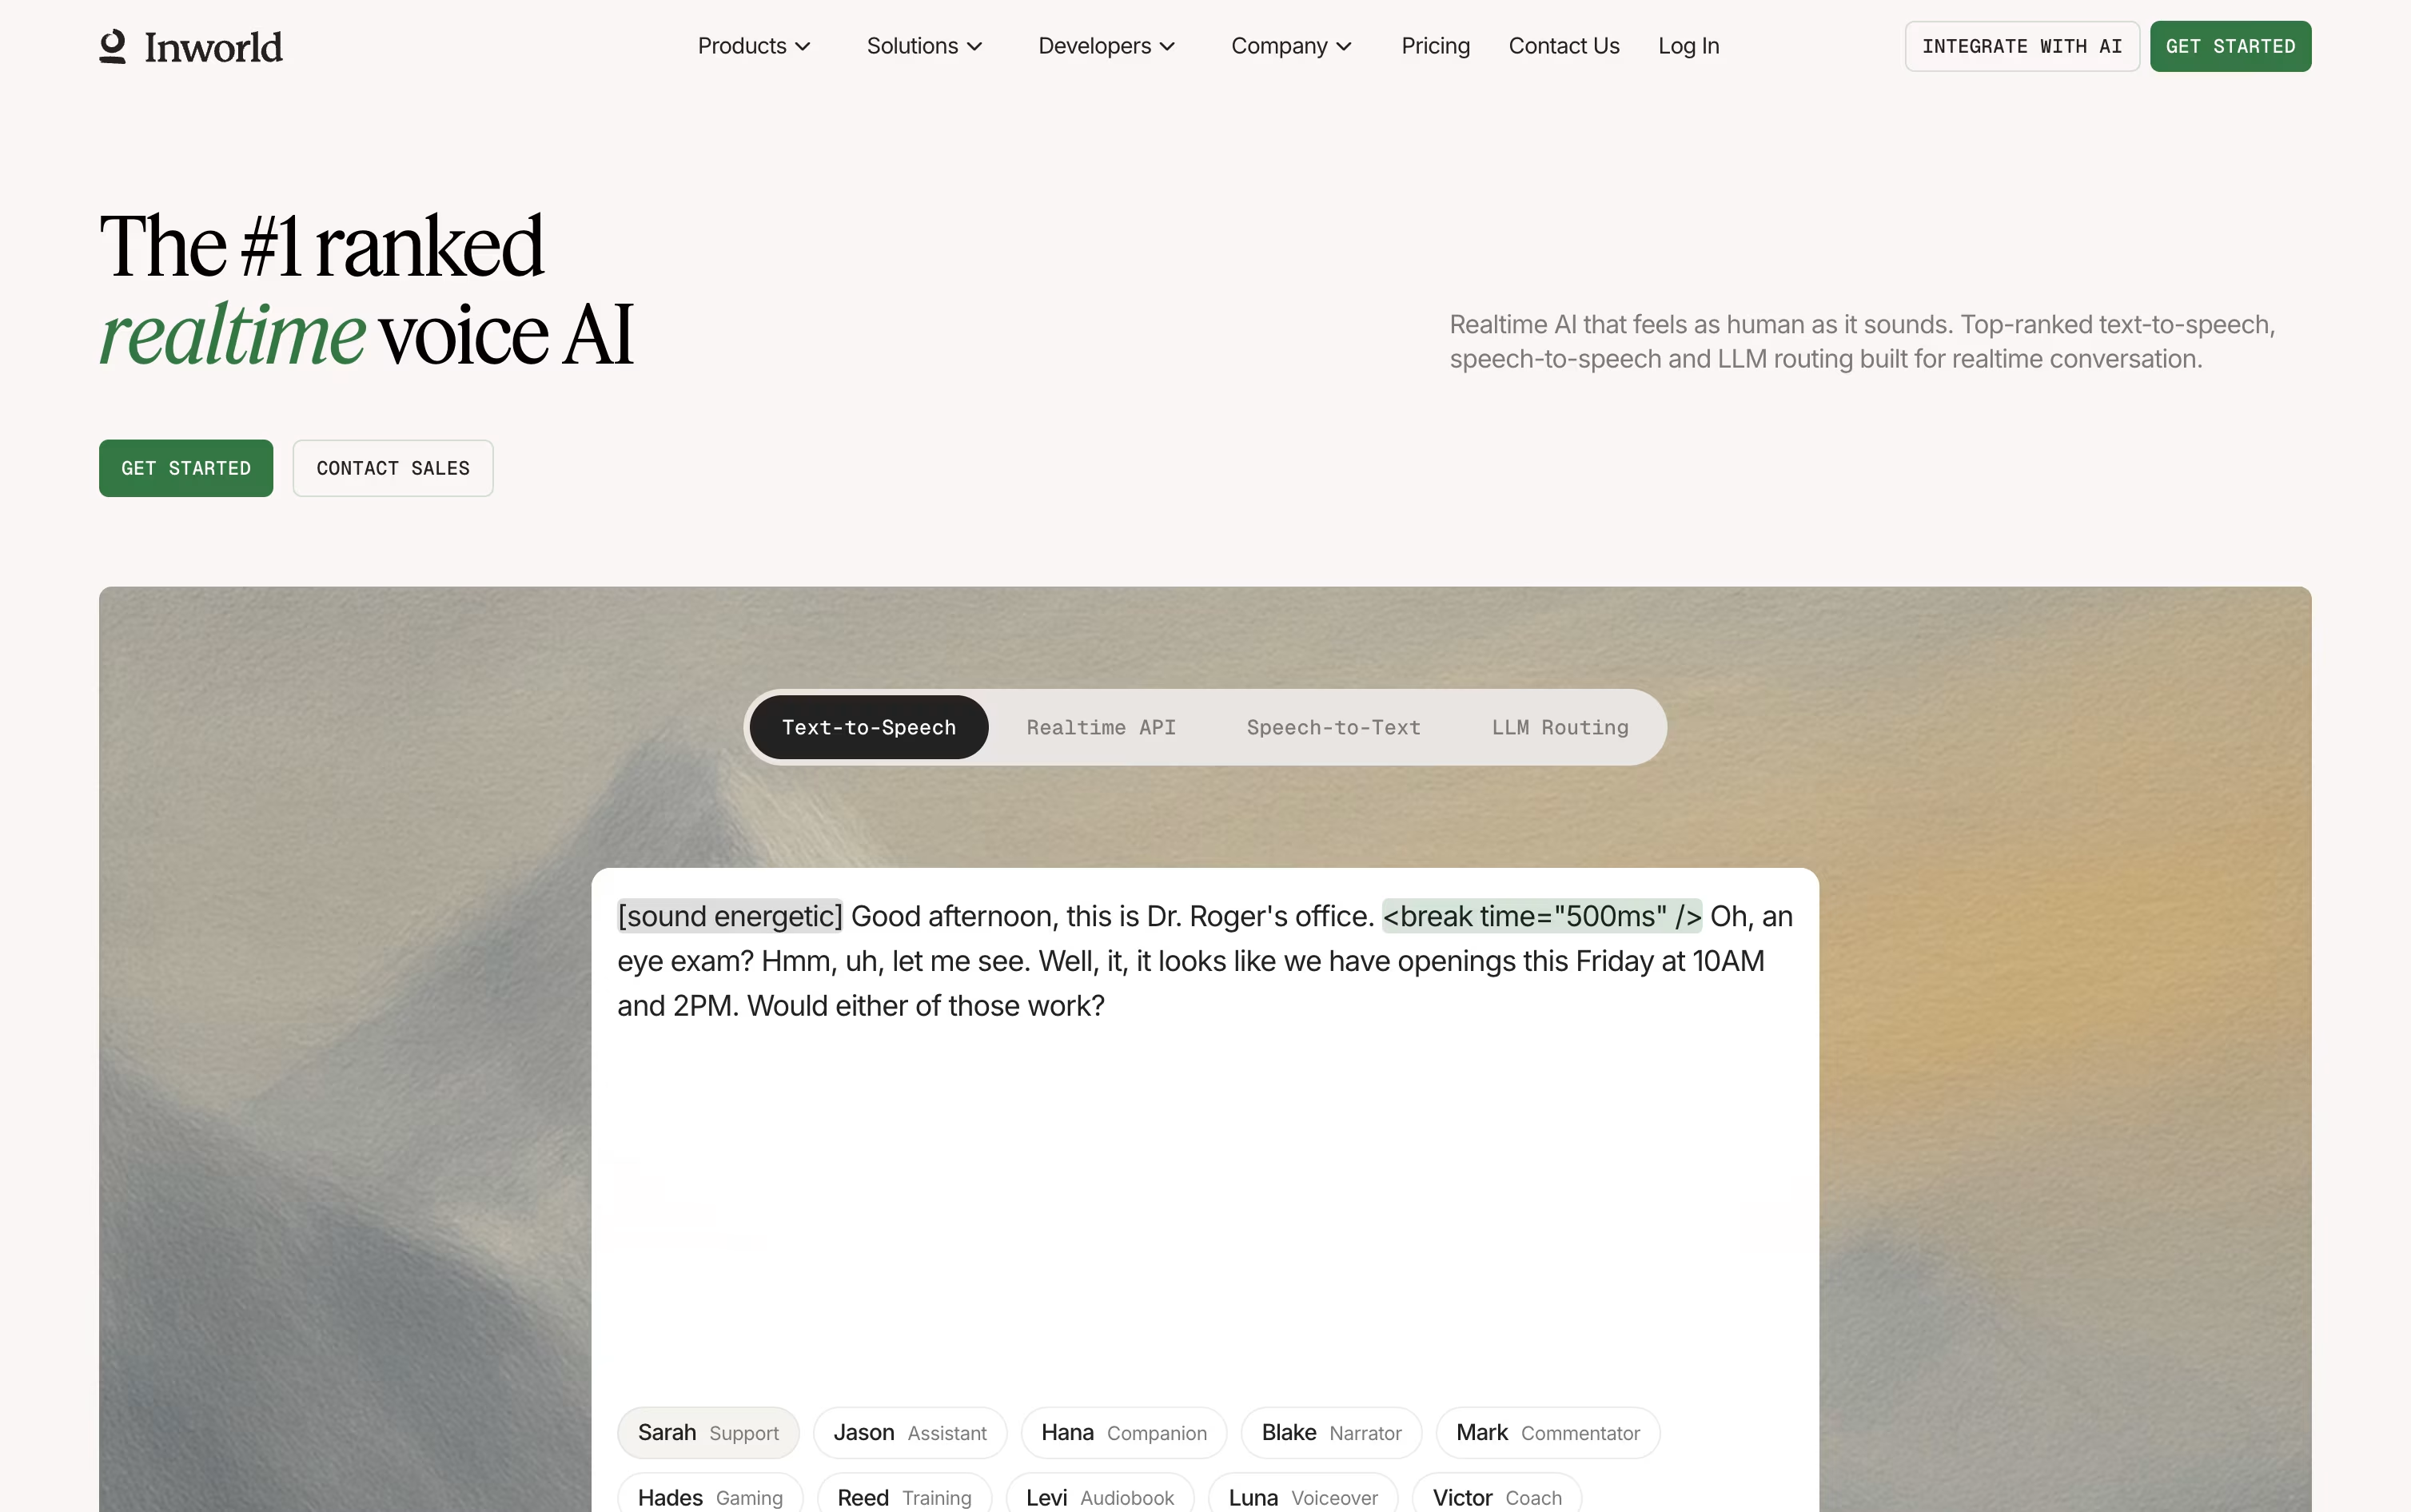
Der kostenlose On-Demand-Plan ist ein guter Einstiegspunkt und bietet rund 70 Minuten Sprachgenerierung, 100 benutzerdefinierte Stimmen sowie Zugriff auf die Realtime-API und den LLM Router mit über 220 Modellen.
Bezahlte Tarife skalieren von Creator für 25 $ pro Monat bis zu Growth für 1.500 $ pro Monat. Jeder senkt die Kosten pro Zeichen und pro Stunde und erhöht gleichzeitig die Anzahl der benutzerdefinierten Stimmen und gleichzeitigen Sitzungen.
Die Preise für zeichenbasiertes TTS reichen von 25 $ pro Million Zeichen im kostenlosen Plan bis zu 12,50 $ bei Growth, wobei Enterprise-Kunden Preise von bis zu 5 $ aushandeln können. Speech-to-Text beginnt bei 0,15 $ pro Stunde und sinkt bei jedem kostenpflichtigen Plan auf 0,10 $.
Für größere Organisationen fügt Enterprise benutzerdefinierte Limits, lokale Hosting-Optionen, Datenresidenz und einen dedizierten Account-Manager hinzu, sowie SOC 2 Type II-, HIPAA- und GDPR-Compliance, die in die Plattform integriert ist.
Die meisten Sprachassistenten lesen Text laut vor, ohne wirkliches Gespür für den Moment. Hume AI verfolgt einen anderen Ansatz und baut eine Empathic Voice Interface auf, die auf Ton und Emotion hört und dann mit einer Stimme antwortet, die tatsächlich zum Gefühl des Gesprächs passt.
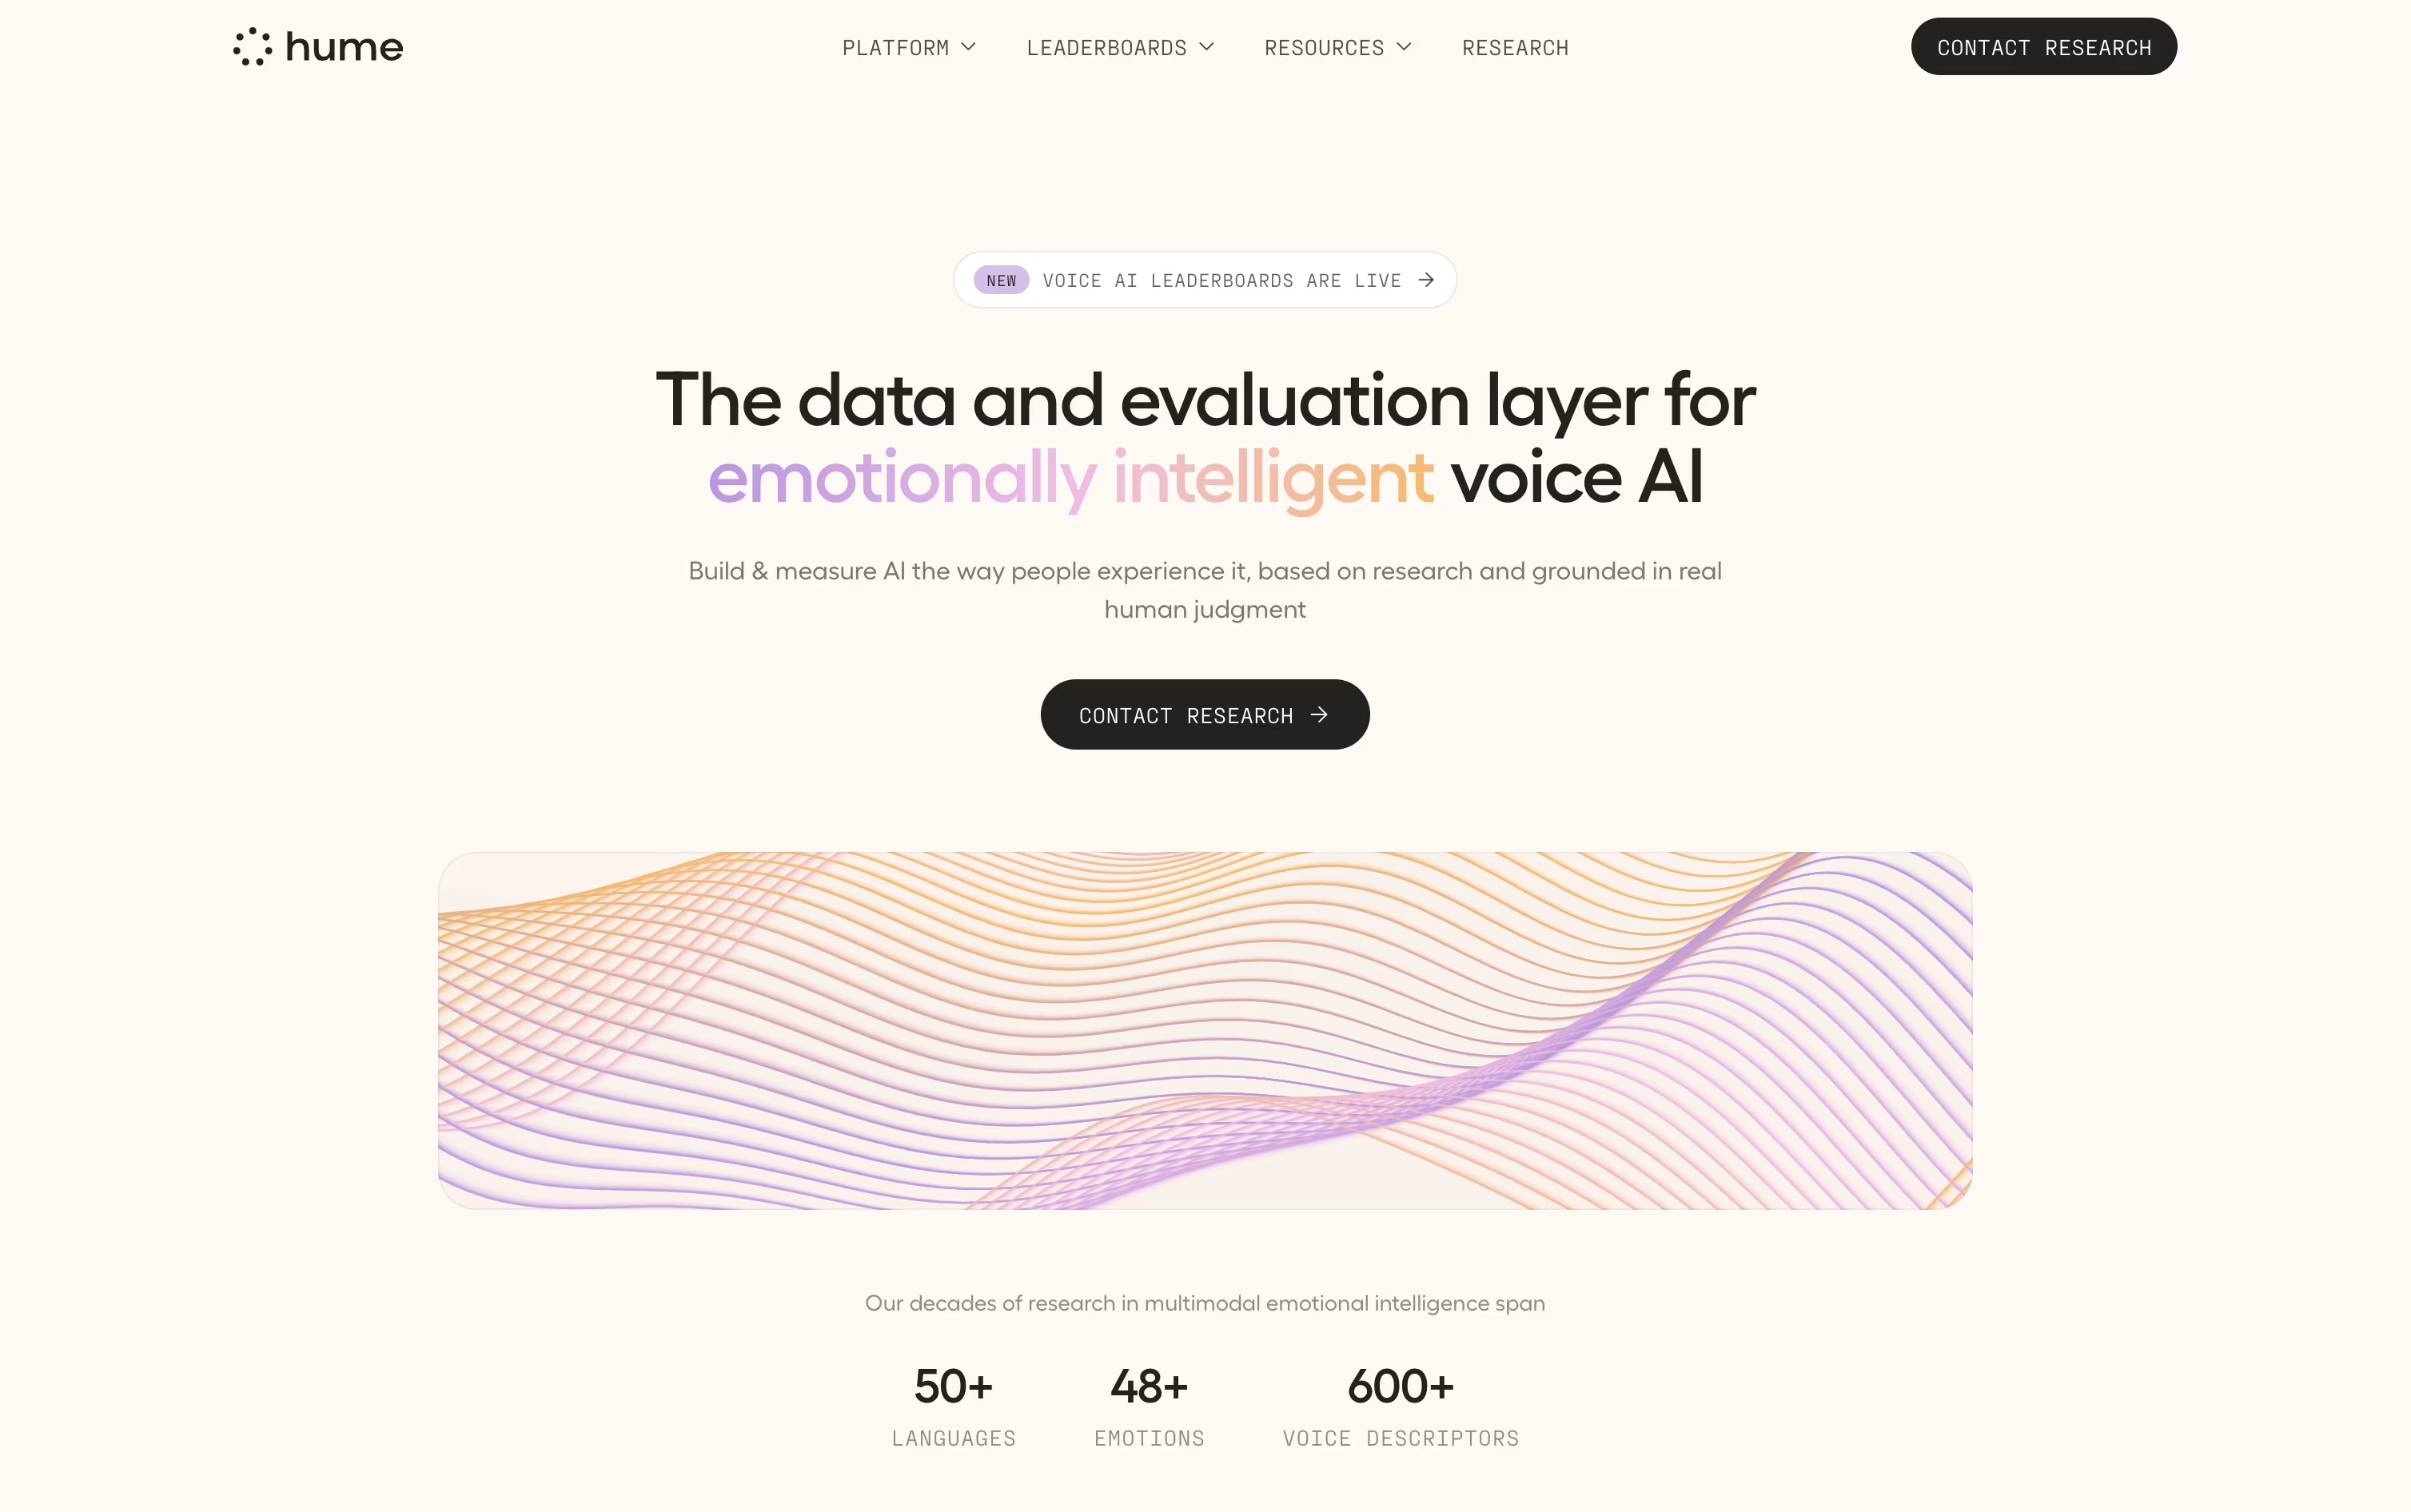
Sein Octave Text-to-Speech-Modell funktioniert auf die gleiche Weise und nutzt den Kontext, um Tonhöhe, Tempo und Betonung zu steuern, anstatt mit einer flachen, mechanischen Stimme zu lesen.
Ein kostenloser Plan ist verfügbar, mit 10.000 Zeichen Sprache und 5 Minuten Sprach-Konversation pro Monat, genug zum Ausprobieren.
Von dort beginnt Starter bei 3 $ pro Monat; Creator, Pro, Scale und Business erhöhen jeweils Nutzung, Anforderungsgeschwindigkeit und senken die Übernutzungspreise.
Unternehmen, die mehr benötigen, können zu einem individuellen Enterprise-Plan wechseln, der unbegrenzte Team-Sitzplätze, Slack-basierten Support und Konformität mit SOC 2 Type II, GDPR und HIPAA umfasst.
Da Humes Sprachschicht mit externen Modellen wie Claude, GPT und Gemini funktioniert, können Teams das Gehirn hinter dem Assistenten ändern, ohne die Klangqualität zu verändern.
Statt einer flachen, maschinenartigen Stimme verwandelt Typecast Ihr Skript in Sprache, die wie eine echte Person mit Gefühl spricht. Es basiert auf Sprachaufnahmen professioneller Schauspieler und einem Modell namens SSFM, das Neosapience über mehrere Jahre entwickelt hat.
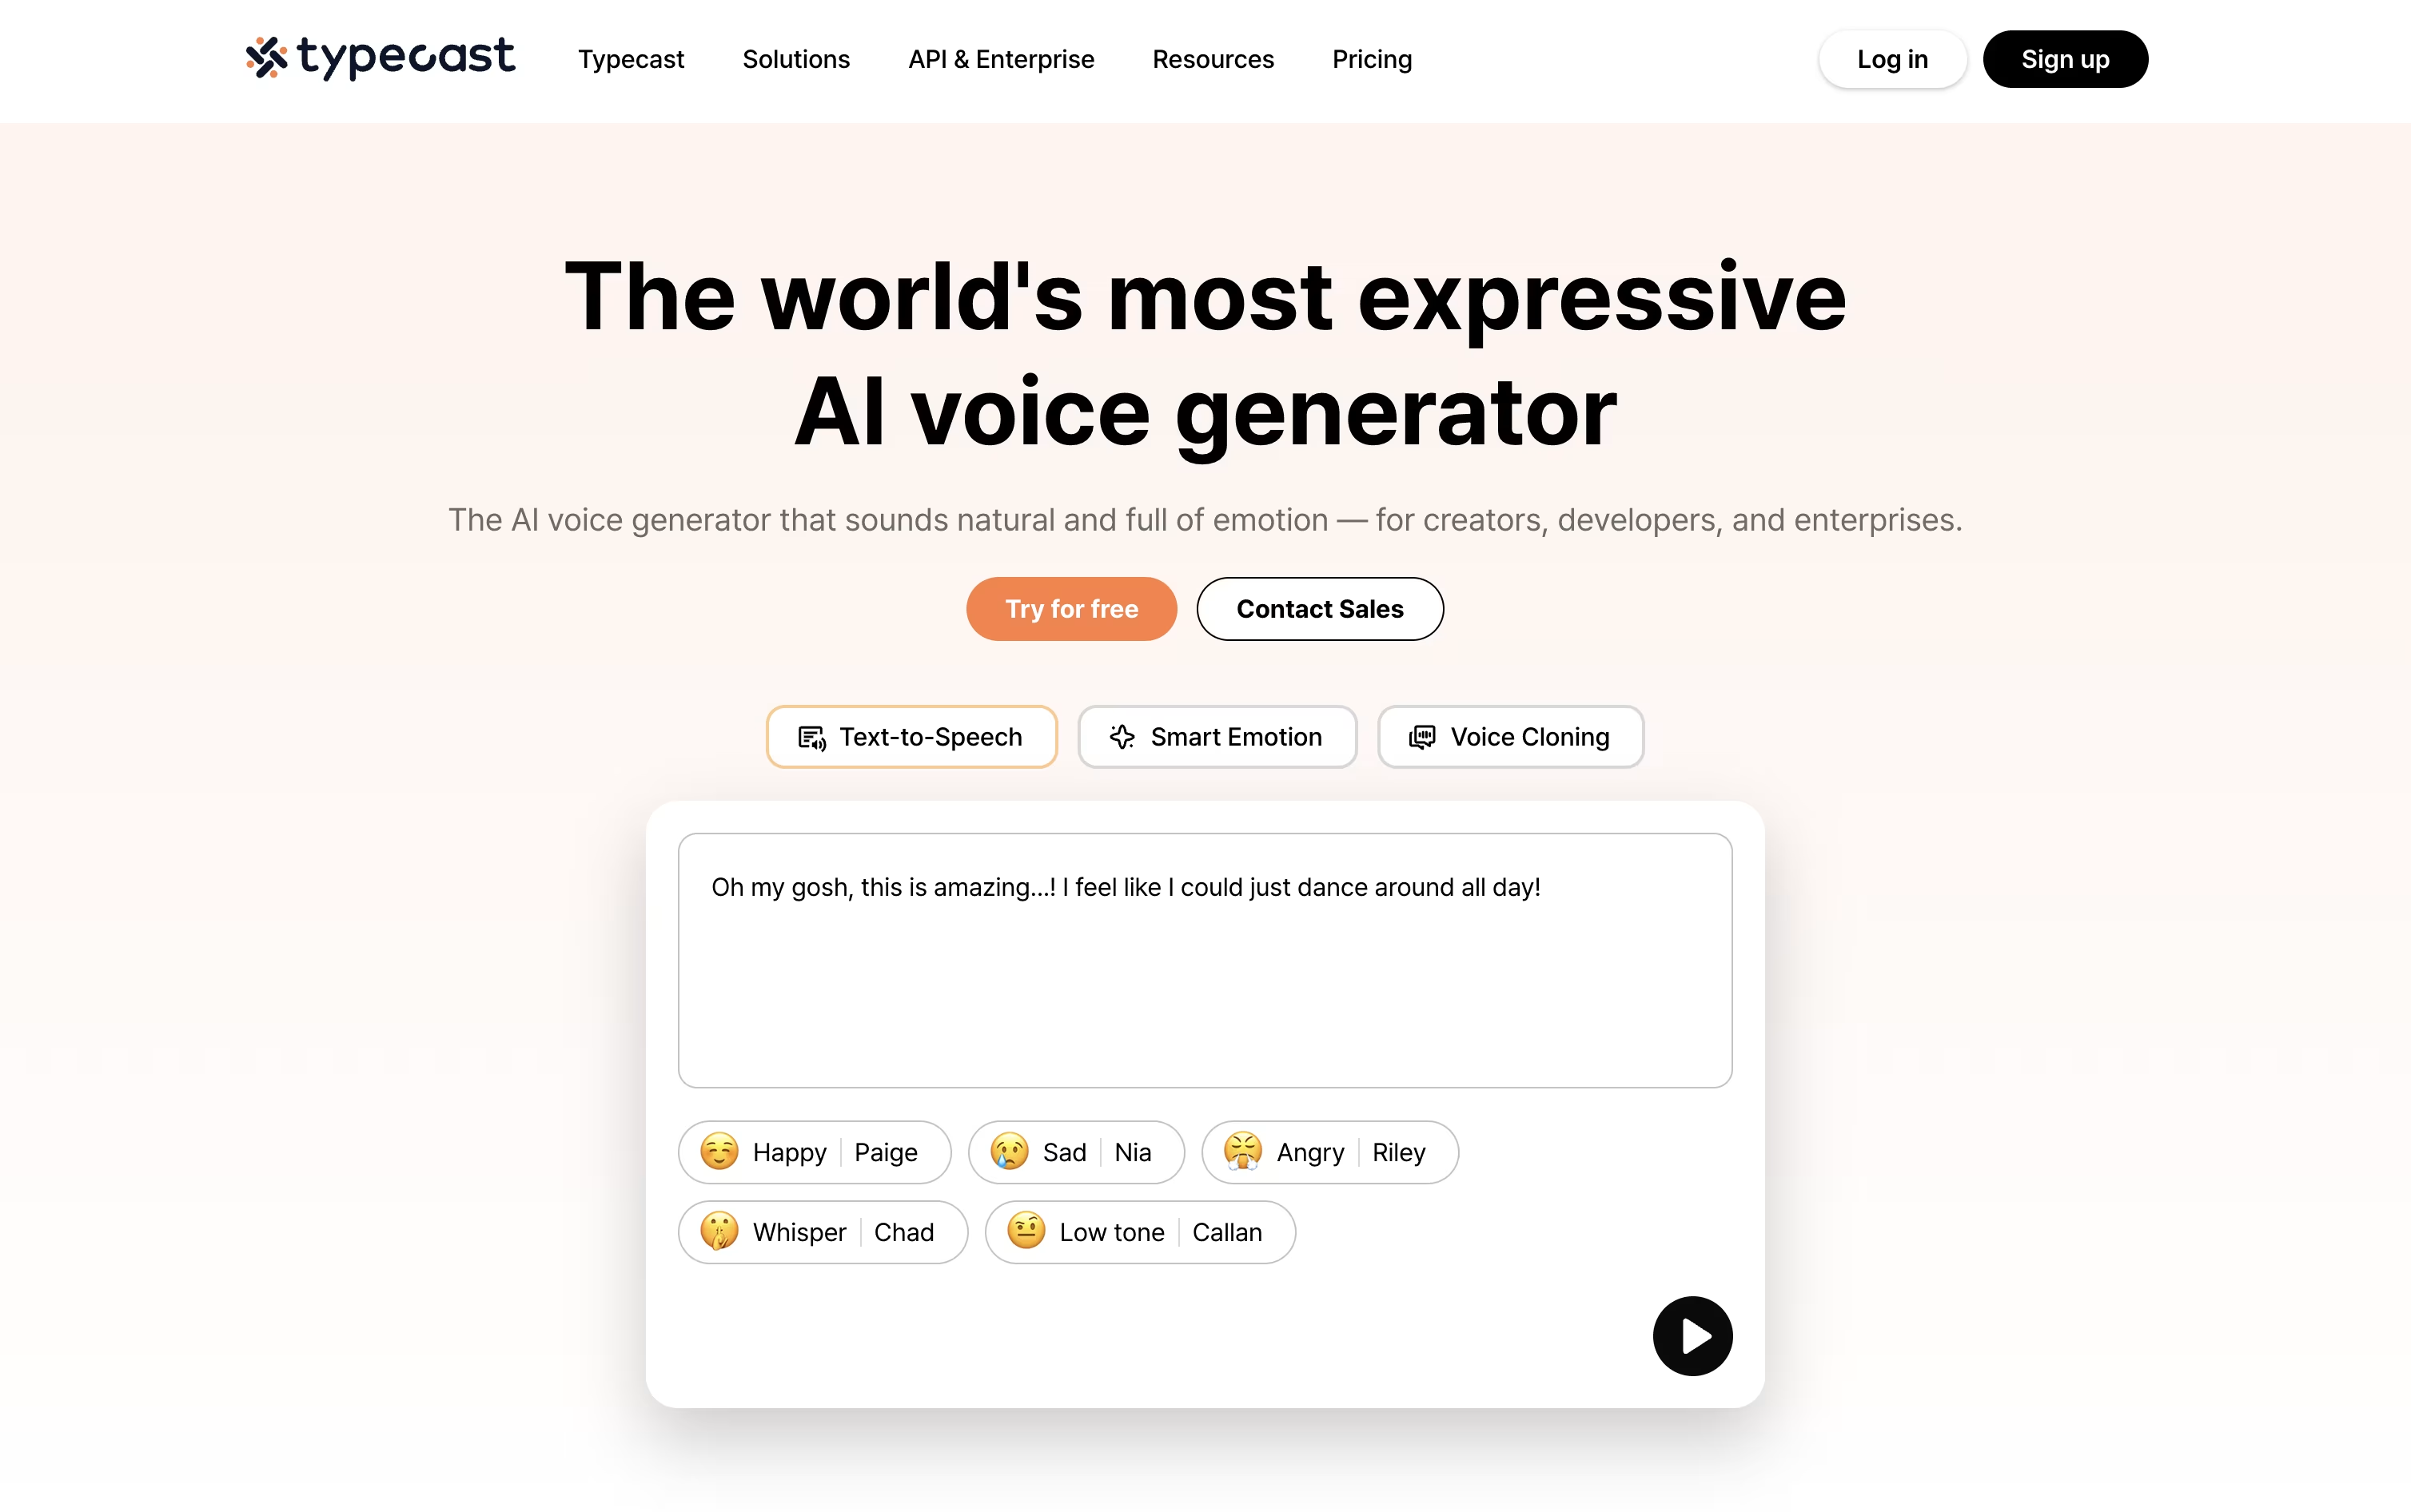
Das herausragende Merkmal ist Smart Emotion, das Ihren Text liest und automatisch den richtigen emotionalen Ton anwendet. Sie können auch manuell eingreifen, eine Emotion wählen, die Tonhöhe anpassen und die Geschwindigkeit für mehr Kontrolle ändern.
Ein integrierter Videoeditor ermöglicht es Ihnen, über Audio hinauszugehen, indem Sie Bilder, Hintergründe, Musik und einen KI-Avatar mit Lippensynchronisation hinzufügen, sodass ein Skript zu einem fertigen Video für YouTube, Marketing oder E-Learning wird.
Entwickler erhalten eine vollständige API und SDKs in vielen Programmiersprachen mit Streaming und zeitgestempeltem Audio, um Sprachfunktionen in Apps oder Echtzeit-Assistenten zu integrieren.
Was den Preis betrifft, beginnen Studio-Pläne kostenlos und steigen bis zu 69 $ pro Monat für die Business-Stufe, während eine separate API-Strecke kostenlos beginnt und mit der Nutzung wächst, mit kundenspezifischen Preisen für große Enterprise-Anforderungen.
Rime AI wandelt Text in Sprache um, die wie ein echter Mensch klingt, und ist daher ideal für Sprachagenten, Kundenanrufe und automatisierte Telefonsysteme.
Die Preisgestaltung erfolgt nutzungsbasiert, sodass Sie nur für das bezahlen, was Sie generieren. Sie beginnt bei 0,03 $ pro 1.000 Zeichen, und neue Konten erhalten etwa 800 Minuten kostenlos, ohne dass eine Kreditkarte erforderlich ist.
Es werden zwei Modelle angeboten. Mist v3 reagiert am schnellsten, während Coda auf natürlich klingende, ausdrucksstarke Sprache ausgerichtet ist und mehr Sprachen abdeckt.
Der Starter-Plan unterstützt 20 gleichzeitige Sprachgenerierungen sowie Streaming-Audio, Wort-für-Wort-Zeitstempel und präzise Kontrolle über die Aussprache von Namen und Zahlen.
Größere Teams können zu Enterprise wechseln für individuelle Preise, unbegrenzte gleichzeitige Generierungen, unbegrenztes Voice Cloning und Bereitstellung in der Cloud, vor Ort oder im privaten Netzwerk.
Enterprise-Kunden erhalten außerdem HIPAA-Konformität und SOC-2-Typ-II-Berichte für den sicheren Umgang mit sensiblen Gesprächen.